|
|
|
|
|
|
|
|
|
|
|
| Partitioned Memory
Parallel Programming Library (PMLIB) |
|
|
|
| Based on BSP-RAMP:
Partitioned Memory Parallel Programming Framework |
|
|
|
| |
|
|
Prof.
Subodh Kumar |
Prof.
Sorav Bansal |
|
|
|
|
|
|
| Tarun Beri |
|
|
|
| Indian Institute of
Technology, Delhi |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Monte Carlo Stock Pricing |
|
|
|
|
|
|
| Experimental
Configuration |
|
5 |
|
| Four 64-bit Ubuntu
Linux 8.04.2 Eight Core Machines [Intel Xeon CPU E5450 3.00 GHz with 16 GB
physical memory]; |
|
2 |
|
| Two machines have
one Tesla C1060 GPU Card each |
|
3 |
|
| Watch Dog/Kernel
Execution Timeout Disabled; mpiexec with 4 processes on different machines; |
|
|
|
| CUDA Version 3.1; OpenMPI Version 1.78;
OpenMP Version 3.0; gcc Version 4.2.4 |
|
|
|
| Equal task
partitioning among all processing elements |
|
|
|
|
| 1024 Stock Options |
|
| log2(Paths) |
Computation
Time (in seconds) |
|
| |
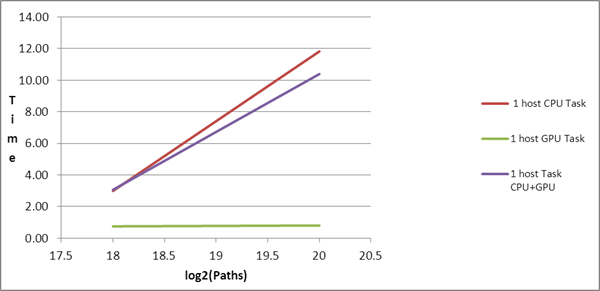
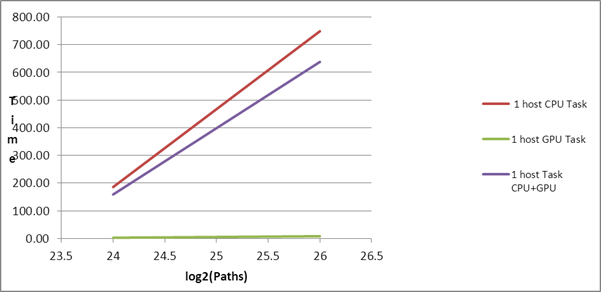
Serial Task |
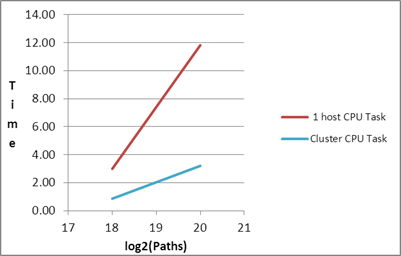
1 host CPU Task |
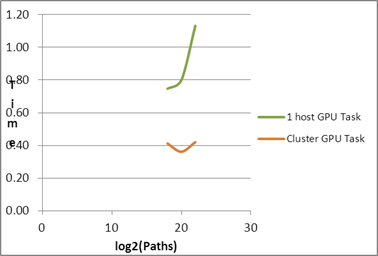
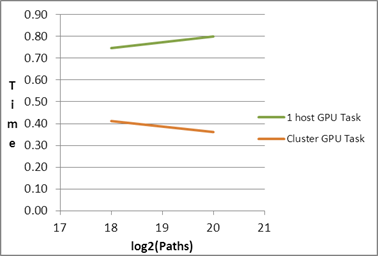
1 host GPU Task |
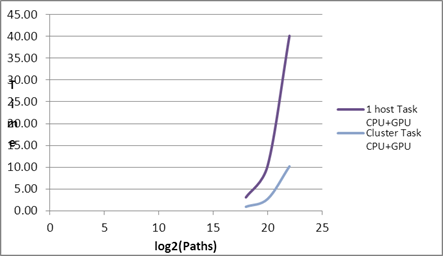
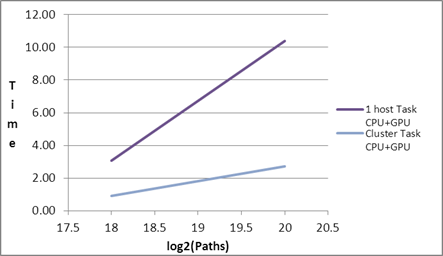
1 host Task
CPU+GPU |
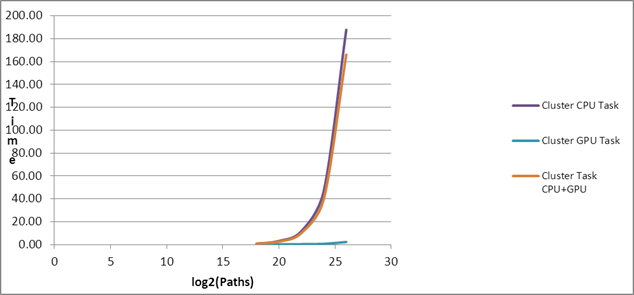
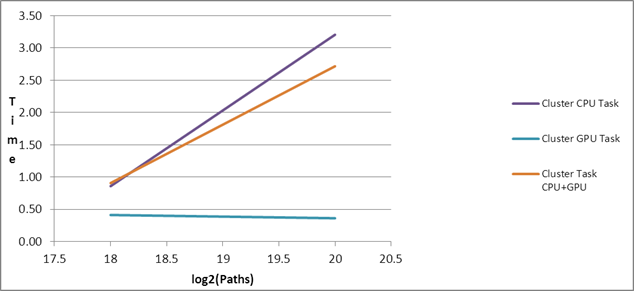
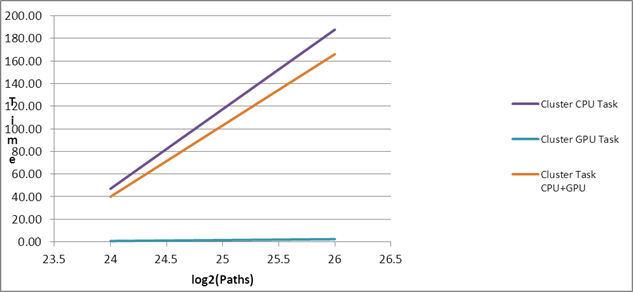
Cluster CPU Task |
Cluster GPU Task |
Cluster Task
CPU+GPU |
|
| 18 |
23.10 |
2.99 |
0.75 |
3.06 |
0.86 |
0.41 |
0.91 |
|
| 20 |
93.03 |
11.82 |
0.80 |
10.39 |
3.21 |
0.36 |
2.72 |
|
| 22 |
369.02 |
46.94 |
1.13 |
40.16 |
11.80 |
0.42 |
10.19 |
|
| 24 |
1472.97 |
185.66 |
2.49 |
158.74 |
46.99 |
0.73 |
39.96 |
|
| 26 |
5891.24 |
748.85 |
7.93 |
638.09 |
187.67 |
2.34 |
165.98 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
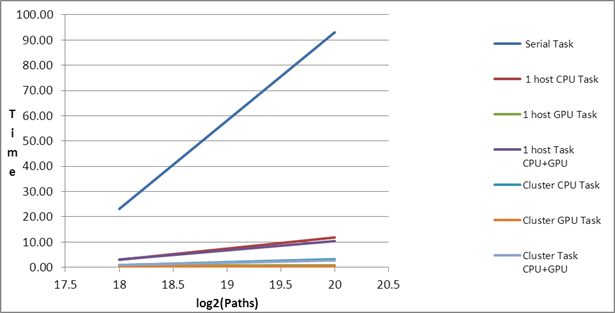
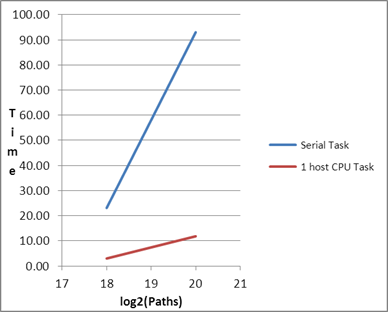
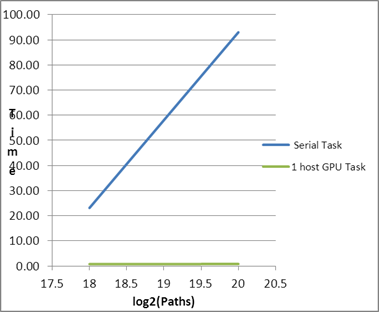
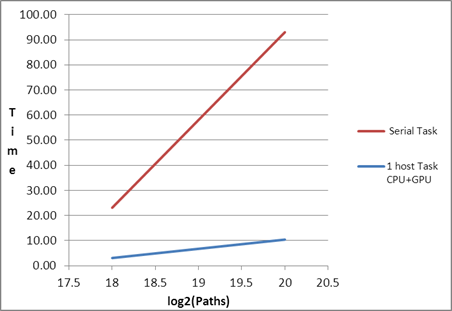
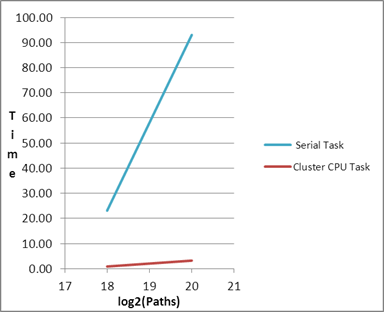
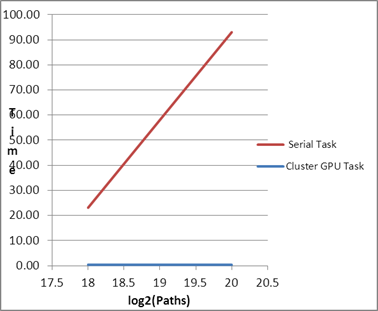
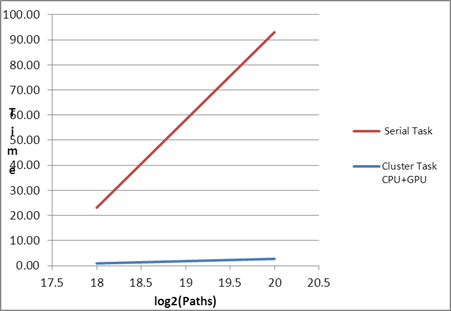
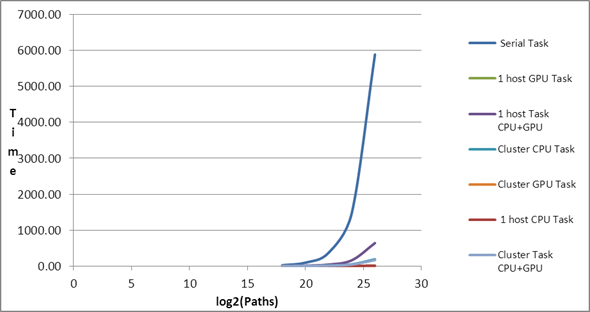
| Comparison of
Serial and PMLIB Tasks |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
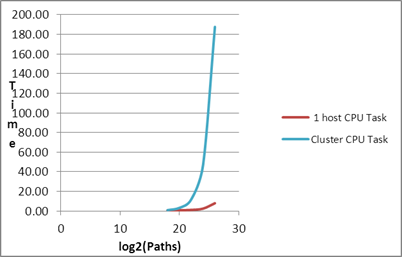
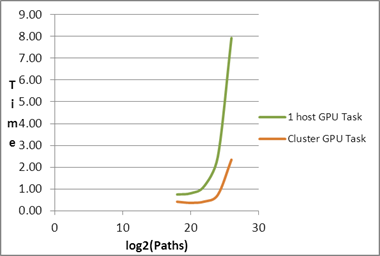
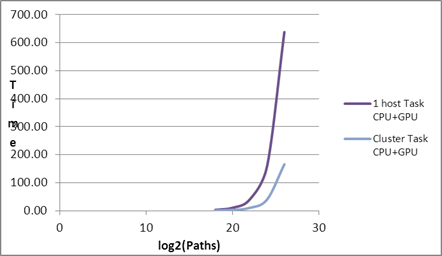
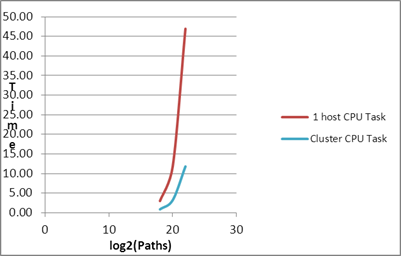
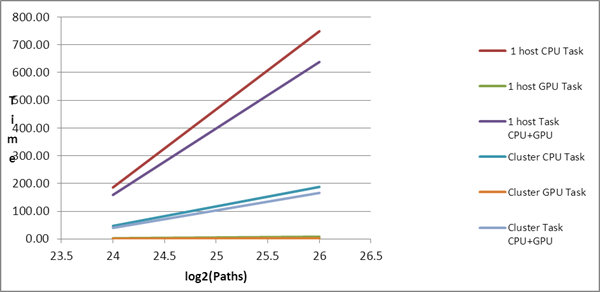
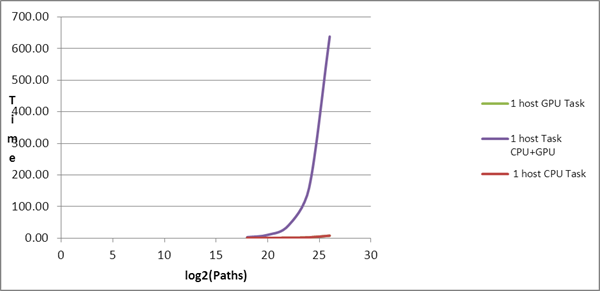
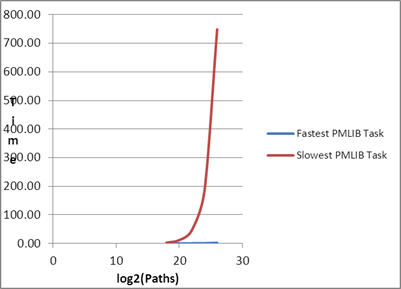
| Comparison of PMLIB
Tasks |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
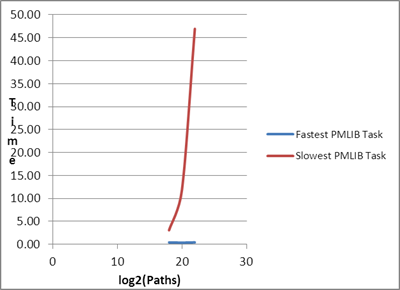
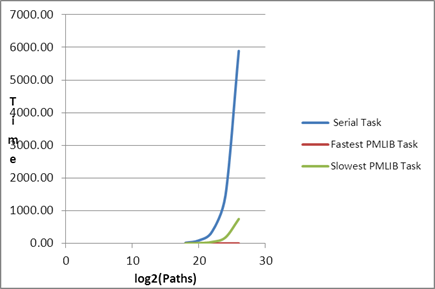
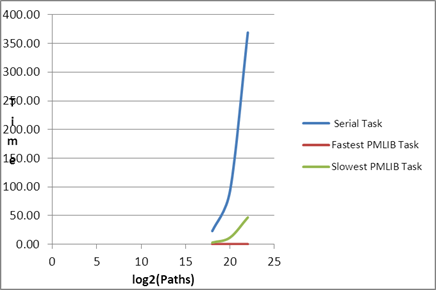
| Comparison of
Serial Task, Fastest PMLIB Task and Slowest PMLIB Task |
|
| log2(Paths) |
Computation
Time (in seconds) |
|
| |
Serial Task |
1 host CPU Task |
1 host GPU Task |
1 host Task
CPU+GPU |
Cluster CPU Task |
Cluster GPU Task |
Cluster Task
CPU+GPU |
Fastest PMLIB Task |
Slowest PMLIB Task |
|
| 18 |
23.096 |
2.990 |
0.75 |
3.06 |
0.86 |
0.41 |
0.91 |
0.412 |
3.06 |
|
| 20 |
93.03 |
11.82 |
0.80 |
10.39 |
3.21 |
0.36 |
2.72 |
0.36 |
11.82 |
|
| 22 |
369.02 |
46.94 |
1.13 |
40.16 |
11.80 |
0.42 |
10.19 |
0.42 |
46.94 |
|
| 24 |
1472.97 |
185.66 |
2.49 |
158.74 |
46.99 |
0.73 |
39.96 |
0.73 |
185.66 |
|
| 26 |
5891.24 |
748.85 |
7.93 |
638.09 |
187.67 |
2.34 |
165.98 |
2.34 |
748.85 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Fastest LPC Task |
Slowest LPC Task |
|
|
|
|
|
|
|
|
|
|
| log2(Paths) |
Computation
Time (in seconds) |
% Speedup of PMLIB Task over Serial Task |
|
|
|
|
|
| |
Serial Task |
Fastest PMLIB Task |
Slowest PMLIB Task |
Fastest PMLIB Task |
Slowest PMLIB Task |
|
|
|
| 18 |
23.096 |
0.412 |
3.06 |
5609.74 |
753.82 |
|
| 20 |
93.03 |
0.36 |
11.82 |
25747.84 |
786.79 |
|
| 22 |
369.02 |
0.42 |
46.94 |
87862.38 |
786.22 |
|
| 24 |
1472.97 |
0.73 |
185.66 |
201784.88 |
793.35 |
|
Max PMLIB Speedup over Serial Task |
|
| 26 |
5891.24 |
2.34 |
748.85 |
251414.46 |
786.71 |
|
2514.14x |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
PMLIB Tasks
slower than Serial Task |
PMLIB Tasks
faster than Serial Task |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| |
|
|
|
|
|
|
|
|
|
|
|